Tối ưu hiệu năng truy cập dữ liệu bằng kế hoạch truy vấn và chỉ mục
Tốc độ của phần mềm thường phụ thuộc vào cơ sở dữ liệu. Giao diện có thể hiển thị nhanh, nhưng người dùng vẫn phải chờ khi báo cáo quét hàng triệu dòng hoặc quy trình thanh toán thực hiện cùng một phép tra cứu lặp đi lặp lại. Hướng dẫn này giải thích cách tối ưu câu truy vấn cơ sở dữ liệu chậm bằng cách đọc kế hoạch truy vấn, chọn các chỉ mục hữu ích và đo lường kết quả mà không引入 thêm rủi ro mới.
Bắt đầu với mục tiêu hiệu năng rõ ràng
Trước khi thay đổi SQL, hãy định nghĩa thế nào là cải thiện. Ghi lại thời gian phản hồi hiện tại ở quy mô dữ liệu thực tế, lưu ý tần suất chạy truy vấn và xác định phần mà người dùng trải nghiệm trực tiếp. Một truy vấn chạy mỗi đêm một lần có những ràng buộc khác với truy vấn được gọi ở mọi lần tải trang.
Thu thập một bộaseline nhỏ:
- Độ trễ: thời lượng trung bình và phần trăm cao khi tải bình thường.
- Tần suất: số lần gọi mỗi phút, mỗi người dùng hoặc mỗi giao dịch.
- Số dòng được quét: lượng dữ liệu mà bộ máy đọc để trả kết quả.
- Sử dụng tài nguyên: CPU, bộ nhớ, phép đọc ổ đĩa và thời gian chờ khóa.
Giữ cửa sổ đo lường nhất quán. So sánh cùng bộ dữ liệu, phần cứng và mức độ đồng thời để các thay đổi sau này có ý nghĩa.
Đọc kế hoạch truy vấn trước khi thay đổi câu lệnh
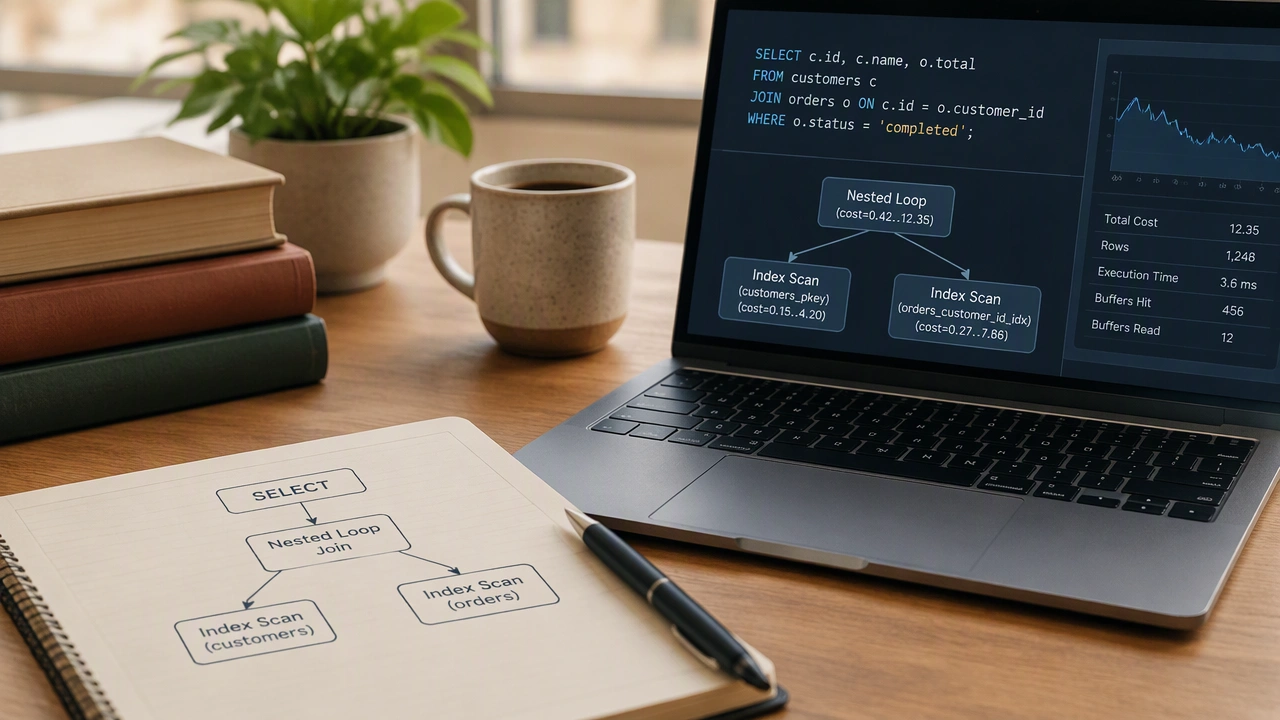
Kế hoạch truy vấn là lời giải thích của bộ tối ưu hóa cơ sở dữ liệu về cách nó sẽ thực thi một câu lệnh. Kế hoạch khác nhau tùy engine, nhưng hầu hết đều hiển thị các ý tưởng cơ bản giống nhau: phương thức truy cập, thứ tự liên kết, số dòng ước tính và công việc thực tế được thực hiện.
Hãy tìm các tín hiệu sau:
- Quét toàn bộ: bộ máy đọc toàn bộ bảng thay vì một phạm vi hẹp.
- Ước tính số dòng lớn: các ước tính lệch xa giá trị thực cho thấy thống kê đã lỗi thời hoặc biểu thức gây hiểu nhầm.
- Phép liên kết tốn kém: vòng lặp lồng nhau trên đầu vào lớn thường cho thấy thiếu chỉ mục hoặc thứ tự liên kết kém.
- Sắp xếp và tràn bộ nhớ: sắp xếp các kết quả trung gian lớn có th��� buộc phải ghi tạm ra ổ đĩa.
- Công việc lặp lại: cùng một truy vấn con hoặc hàm có thể chạy cho mỗi dòng.
Chụp cả kế hoạch ước tính và, khi có sẵn, kế hoạch thực tế với số dòng chạy thực. Sự khác biệt giữa ước tính và thực tế thường là manh mối hữu ích nhất.
Khớp chỉ mục với đường dẫn truy cập thực tế
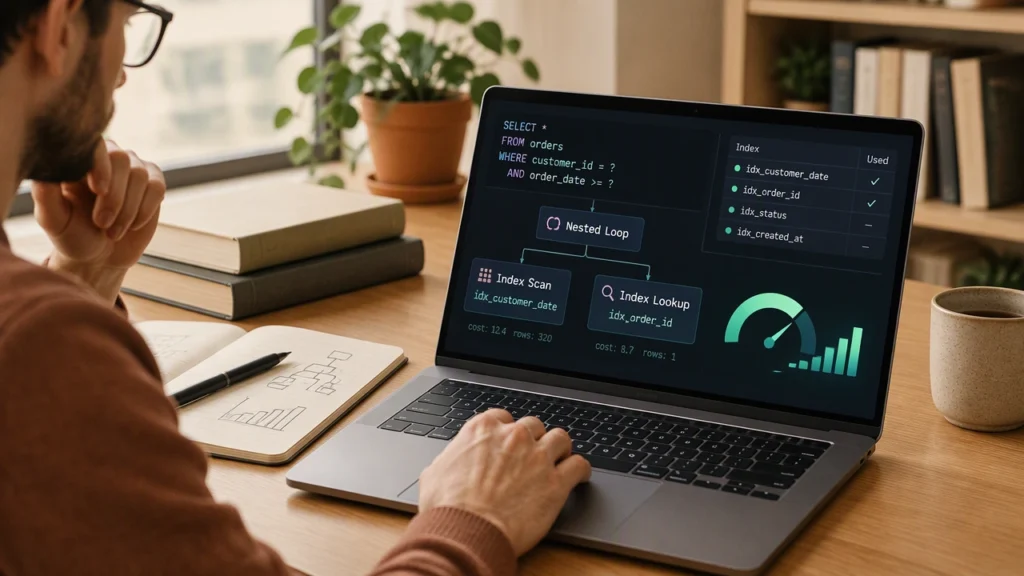
Chỉ mục là một cấu trúc riêng biệt giúp bộ máy định vị dòng mà không cần quét toàn bộ bảng. Chỉ mục tốt nhất phù hợp với cách ứng dụng thực sự đọc dữ liệu.
Bắt đầu với các điều kiện lọc hoặc sắp xếp thường xuyên. Chỉ mục tổng hợp thường hoạt động tốt nhất khi các cột của nó tuân theo mô hình này: các cột dùng cho phép lọc bằng trước, sau đó là cột dùng cho phạm vi lọc hoặc sắp xếp. Ví dụ, một truy vấn lọc theo trạng thái và sắp xếp theo thời gian tạo có thể hưởng lợi từ chỉ mục trên status và created_at.
Hãy ghi nhớ các giới hạn sau:
- Quy tắc cột đầu: hầu hết các engine đều sử dụng các cột ngoài cùng bên trái của chỉ mục tổng hợp trước.
- Tính chọn lọc: cột có nhiều giá trị trùng lặp có thể cần thêm cột thứ hai để thực sự hữu ích.
- Chi phí ghi: mỗi chỉ mục đều thêm công việc bảo trì cho các thao tác chèn, cập nhật và xóa.
- Biểu thức hàm: nếu truy vấn áp dụng hàm lên cột, hãy cân nhắc sử dụng chỉ mục biểu thức hoặc viết lại điều kiện lọc.
Đừng thêm chỉ mục chỉ dựa trên trực giác. Xác nhận bằng kế hoạch rằng bộ máy chọn đường dẫn mới và số dòng ước tính giảm xuống phạm vi hợp lý.
Cải thiện SQL xung quanh kế hoạch
Chỉ mục không thể thay thế SQL rõ ràng, có tính chọn lọc. Những thay đổi nhỏ thường loại bỏ được công việc ẩn.
Chỉ chọn các cột cần thiết. Tránh SELECT * khi ứng dụng chỉ dùng vài trường. Dòng rộng tăng sử dụng bộ nhớ và có thể ngăn truy cập chỉ mục bao phủ.
Lọc sớm. Đưa điều kiện vào truy vấn bên trong để bộ máy có thể giảm số dòng trước khi liên kết hoặc nhóm. Đảm bảo logic vẫn đúng khi điều kiện liên quan đến cột có thể chứa giá trị null.
Hạn chế các thao tác tốn kém. Phân trang bằng OFFSET có thể bỏ qua nhiều dòng ở các trang sâu. Phân trang bằng khóa chính, sử dụng giá trị sắp xếp cuối cùng đã thấy, giữ công việc tỷ lệ với kích thước trang.
Chú ý chuyển đổi ngầm. So sánh cột văn bản với số, hoặc sử dụng quy tắc sắp xếp khác, có thể vô hiệu hóa chỉ mục. Giữ kiểu tham số khớp với kiểu cột.
Giảm các mẫu N+1. Các phép tra cứu lặp lại từng dòng từ mã ứng dụng có thể làm quá tải một truy vấn nhanh. Gom nhóm yêu cầu hoặc sử dụng một câu lệnh tập hợp khi mô hình dữ liệu cho phép.
Xác nhận thay đổi bằng thử nghiệm có kiểm soát
Thay đổi từng thứ một. Chạy lại truy vấn bằng cùng phương pháp chụp kế hoạch và so sánh số dòng đọc, thời gian thực thi và sử dụng tài nguyên. Kiểm tra với số lượng bản ghi tương tự sản phẩm; một chỉ mục trông hoàn hảo trên mười dòng có thể hoạt động khác trên mười triệu dòng.
Kiểm tra các tác dụng phụ:
- Độ trễ ghi và tăng dung lượng lưu trữ sau khi thêm chỉ mục.
- Khóa tranh chấp trong quá trình cập nhật nặng.
- Ổn định kế hoạch khi tham số thay đổi.
- Hành vi khi tải đồng thời, không chỉ trong một phiên đơn lẻ.
Nếu một truy vấn cải thiện nhưng toàn bộ giao diện không, hãy kiểm tra các bước xung quanh. Các cuộc gọi mạng, tuần tự hóa và truy vấn lặp lại có thể chiếm phần lớn thời gian tổng.
Biến việc tối ưu hóa thành thói quen
Hiệu năng cơ sở dữ liệu thay đổi khi dữ liệu phát triển và mô hình truy cập tiến hóa. Giữ một danh sách ngắn các truy vấn quan trọng, ghi lại kế hoạch cơ sở của chúng và xem xét lại sau các bản phát hành lớn hoặc di chuyển dữ liệu quy mô lớn. Làm mới thống kê thường xuyên và theo dõi các kế hoạch chuyển đổi bất ngờ.
Một quy trình bình tĩnh, có thể lặp lại hoạt động tốt hơn các viết lại đột ngột: đo lường, đọc kế hoạch, thêm chỉ mục nhỏ nhất có ích, đơn giản hóa SQL, sau đó xác minh kết quả. Nhịp điệu đó biến việc tối ưu hóa cơ sở dữ liệu thành một phần có thể dự đoán được của quy trình phát triển phần mềm thay vì phản ứng khẩn cấp.