Trang chủ / Lập hồ sơ hiệu năng
Cơ bản về CPU Profiling: Cách tìm đường dẫn mã tốn kém bằng hồ sơ hiệu năng
Khi ứng dụng chạy chậm, trực giác không phải là công cụ gỡ lỗi hiệu quả. Các nhà phát triển thường suy đoán về điểm tắc nghẽn và tối ưu hóa mã gần như không ảnh hưởng đến hiệu năng, trong khi chi phí thực sự lại ẩn ở nơi khác. CPU profiling thay thế việc suy đoán bằng bằng chứng bằng cách hiển thị chính xác chương trình của bạn dành thời gian xử lý ở đâu. Thay vì đo độ trễ tổng thể, một hồ sơ CPU chia nhỏ quá trình thực thi thành các hàm và dòng mã, tiết lộ các đường dẫn mã tốn kém chi phối thời gian chạy. Việc học cách thu thập và diễn giải các hồ sơ này là một kỹ năng cốt lõi cho bất kỳ ai chịu trách nhiệm về tốc độ phần mềm.
CPU Profiling thực sự đo lường những gì
Một công cụ CPU profiler không dùng đồng hồ bấm giờ để đo thời gian từng hàm. Hầu hết các profiler hiện đại sử dụng phương pháp lấy mẫu: nhiều lần mỗi giây, thường từ 99 đến 1000 Hz, profiler tạm dừng quá trình thực thi và ghi lại ngăn xếp gọi hiện tại. Sau vài giây hoặc vài phút, các mẫu này tạo thành bức tranh thống kê về nơi thời gian được dành ra. Các hàm xuất hiện trong nhiều mẫu nhất chiếm nhiều thời gian CPU nhất. Phương pháp này có chi phí rất thấp và hoạt động tốt để tìm mã nóng, ngay cả trong các hệ thống sản xuất.
Điều quan trọng là phải phân biệt giữa thời gian CPU và thời gian đồng hồ (wall-clock time). Hồ sơ CPU chỉ tính thời gian khi luồng đang thực thi tích cực trên một lõi. Nếu chương trình của bạn đang chờ I/O mạng, ổ đĩa hoặc khóa, thời gian chờ đó sẽ không hiển thị là nóng trong hồ sơ CPU. Đối với những trường hợp này, bạn cần profiling off-CPU hoặc wall-clock. Hiểu sự khác biệt này giúp tránh diễn giải sai: một hàm có vẻ nhanh trong hồ sơ CPU vẫn có thể đang chặn tiến trình ở nơi khác.
Cách đọc hồ sơ CPU để tìm hàm chậm
Biết cách đọc hồ sơ CPU để tìm hàm chậm bắt đầu bằng việc hiểu ba chế độ xem phổ biến mà các profiler cung cấp: flame graph, cây gọi (call tree) và danh sách hàm xếp hạng cao (top functions). Mỗi chế độ hiển thị cùng một dữ liệu từ một góc độ khác nhau, và kết hợp lại chúng giúp các đường dẫn mã tốn kém trở nên rõ ràng.
Bắt đầu từ bức tranh tổng thể: Flame Graph
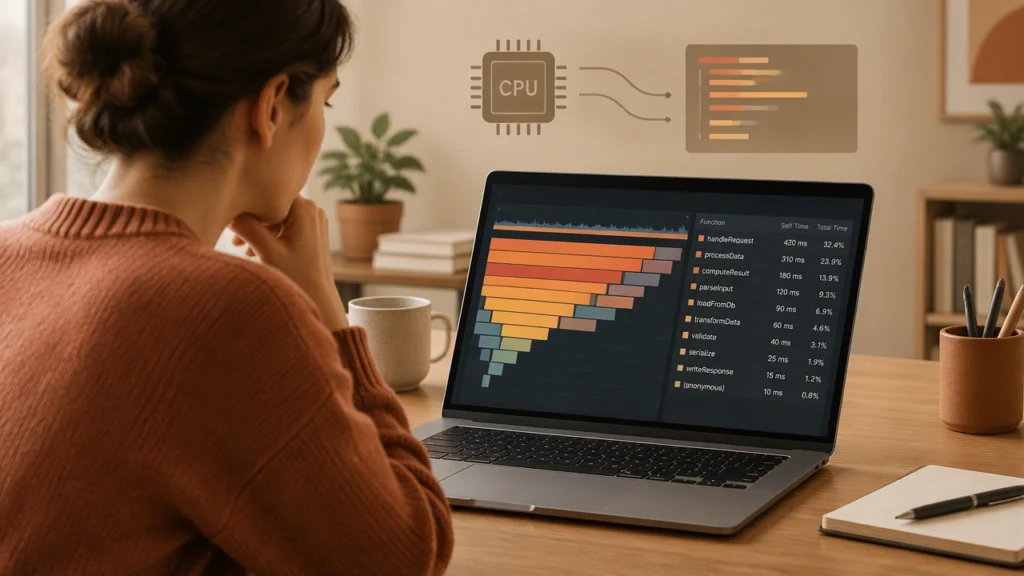
Flame graph trực quan hóa tất cả các ng��n xếp mẫu cùng một lúc. Chiều rộng ngang đại diện cho tỷ lệ mẫu, tương ứng với thời gian CPU. Trục dọc hiển thị độ sâu ngăn xếp, với hàm gọi ở dưới và hàm được gọi ở trên. Để đọc nó, hãy tìm các đỉnh plateau rộng ở gần trên cùng. Một ô rộng nghĩa là một hàm đơn lẻ chiếm tỷ lệ lớn thời gian CPU trong toàn bộ hồ sơ. Nhấn hoặc di chuột để xem phần trăm và số lượng mẫu chính xác. Các tòa tháp rộng nhất thường chỉ thẳng đến các đường dẫn mã tốn kém nhất của bạn, cho dù đó là vòng lặp chặt, phép tính nặng hay các lệnh gọi thư viện không hiệu quả.
Đào sâu với Call Tree và chế độ xem Top-Down
Trong khi flame graph rất tuyệt vời cho cái nhìn tổng quan, call tree cung cấp cho bạn các con số chính xác và mối quan hệ cha-con. Trong cây top-down, bạn bắt đầu từ điểm vào, chẳng hạn như hàm main hoặc một trình xử lý yêu cầu, và mở rộng các nút con được sắp xếp theo thời gian tổng (total time). Thời gian tổng bao gồm thời gian dành trong hàm và tất cả các hàm nó gọi. Thời gian tự (self time) chỉ bao gồm thời gian dành bên trong chính hàm đó, loại trừ các hàm được gọi. Nếu một hàm có thời gian tổng cao nhưng thời gian tự thấp, chi phí nằm ở các hàm con của nó. Nếu nó có thời gian tự cao, thân hàm chính là điểm tắc nghẽn và cần được kiểm tra kỹ hơn.
Kiểm tra số liệu: Self Time so với Total Time
Danh sách các hàm xếp hạng cao, thường được gọi là điểm nóng (hot spots) hoặc chế độ xem bottom-up, xếp hạng các hàm theo thời gian tự bất kể ai gọi chúng. Đây là cách nhanh nhất để trả lời mã nào đang thực sự tiêu tốn chu kỳ xử lý. Sắp xếp theo self time và xem năm đến mười mục đầu tiên. Nếu bạn thấy cùng một hàm từ nhiều đường gọi khác nhau, đó là một điểm nóng được chia sẻ. Nếu bạn thấy các hàm bất ngờ, chẳng hạn như định dạng chuỗi, biểu thức chính quy hoặc tuần tự hóa, bạn đã tìm thấy độ phức tạp ngoài ý muốn. Luôn so sánh phần trăm với tổng số mẫu để đánh giá tác động. Tối ưu hóa một hàm chiếm 1% tổng mẫu sẽ không tạo ra sự khác biệt đáng kể, trong khi giảm một nửa điểm nóng 30% sẽ mang lại sự cải thiện rõ rệt về tốc độ.
Các mẫu phổ biến tiết lộ đường dẫn mã tốn kém
Sau khi xem xét nhiều hồ sơ, một số hình dạng xuất hiện lặp đi lặp lại. Việc nhận ra chúng giúp bạn chuyển từ quan sát sang chẩn đoán mà không lãng phí thời gian.
- Đỉnh plateau rộng và phẳng: Một hàm đơn lẻ chiếm ưu thế về chiều rộng ở trên cùng cho thấy vòng lặp chặt hoặc phép tính nặng. Kiểm tra các thuật toán không hiệu quả, chẳng hạn các vòng lặp O(n²), hoặc công việc lặp lại có thể được lưu vào bộ nhớ đệm.
- Tháp cao và hẹp: Ngăn xếp sâu với chiều rộng nhỏ gợi ý độ sâu gọi quá mức hoặc đệ quy. Chi phí có thể là chi phí gọi hoặc việc thiết lập và phá hủy lặp lại ở mỗi tầng.
- Các đỉnh mảnh lặp lại của cùng một hàm: Cùng một tiện ích xuất hiện trong nhiều nhánh khác nhau. Điều này chỉ ra một hàm trợ lý được chia sẻ, như logging, cấp phát bộ nhớ hoặc băm, được gọi quá thường xuyên.
- Các frame thư viện bất ngờ: Các khối lớn bên trong các thư viện tuần tự hóa, nén hoặc xử lý biểu thức chính quy thường có nghĩa là bạn đang định dạng hoặc phân tích cú pháp nhiều hơn mức cần thiết.
- Các frame kernel và thu gom rác: Thời gian đáng kể trong các hệ thống gọi hoặc GC cho thấy áp lực cấp phát bộ nhớ, I/O quá mức hoặc sự xáo trộn bộ nhớ thay vì logic ứng dụng.
Từ hồ sơ đến sửa lỗi: Ưu tiên những gì cần tối ưu hóa
Hồ sơ cho bạn biết thời gian đi đâu, nhưng không phải mọi điểm nóng đều đáng để sửa. Hãy ưu tiên theo mức độ ảnh hưởng và khả thi. Tập trung vào mã bạn kiểm soát xuất hiện gần đầu danh sách self time và nằm trên đường dẫn yêu cầu quan trọng. Chi phí thư viện và runtime khó thay đổi trực tiếp hơn, nhưng bạn thường có thể giảm tần suất gọi chúng.
- Đo lường trước khi thay đổi: Lưu hồ sơ cơ sở và ghi lại tổng số mẫu, tốc độ yêu cầu và độ trễ để bạn có thể so sánh sau khi sửa.
- Sửa điểm nóng self time lớn nhất trước: Cải thiện 20% trên một điểm nóng 40% có giá trị hơn nhiều so với việc loại bỏ hoàn toàn một hàm chiếm 2%.
- Tìm kiếm lợi thế thuật toán: Thay thế vòng lặp bậc hai, thêm bộ nhớ đệm hoặc gom nhóm I/O thường hiệu quả hơn nhiều so với các tối ưu hóa vi mô.
- Xác minh bằng hồ sơ th��� hai: Sau khi thay đổi, thu thập hồ sơ mới dưới cùng tải để xác nhận điểm nóng đã thu hẹp và không có tắc nghẽn mới nào xuất hiện.
Mẹo Profiling để có kết quả chính xác và khả thi
Dữ liệu tốt giúp việc diễn giải dễ dàng hơn. Hồ sơ nhiều nhiễu hoặc thiên vị có thể dẫn bạn sai lầm vào việc tối ưu hóa sai đường dẫn.
- Profile dưới tải thực tế: Sử dụng lưu lượng truy cập giống môi trường sản xuất hoặc các benchmark đại diện. Tải nhàn rỗi hoặc tổng hợp sẽ tạo ra các hình dạng nhân tạo.
- Thu thập đủ lâu: Mục tiêu ít nhất 30 giây đến vài phút để thu thập hàng ngàn mẫu và làm mượt sự biến thiên.
- Giữ biểu tượng (symbols): Build với biểu tượng debug hoặc các tệp biểu tượng riêng để tên hàm có thể đọc được. Không có biểu tượng, bạn chỉ thấy địa chỉ.
- So sánh các hồ sơ, không chỉ một con số: Các thay đổi nhỏ về thời gian tổng thường bị nhiễu. Hãy tìm sự thay đổi nhất quán về chiều rộng flame graph và phần trăm của các hàm xếp hạng cao.
- Profile lại sau khi triển khai: Đặc điểm hiệu năng thay đổi theo kích thước dữ liệu và hành vi người dùng. Việc profile định kỳ giúp phát hiện sớm các suy giảm hiệu năng.
CPU profiling biến việc tối ưu hiệu năng từ suy đoán thành một quy trình có thể lặp lại: thu thập mẫu, trực quan hóa ngăn xếp, xác định các frame rộng nhất và nóng nhất, và tập trung nỗ lực của bạn vào nơi quan trọng nhất. Với thực hành, việc đọc flame graph hoặc call tree trở nên nhanh chóng và trực giác, giúp bạn phát hiện các đường dẫn mã tốn kém trong vài giây và hướng dẫn các tối ưu hóa mang lại lợi ích thực sự, có thể đo lường được.